طراحی یک CI/CD (continuous integration/continuous delivery/deployment) برای هر پروژه ای یک نیاز حیاتی برای خودکار سازی فرایند های تست و بررسی تغییرات اعمال شده و اعمال کردن تغییرات جدید روی سرویس های در حال اجرا محصول است.
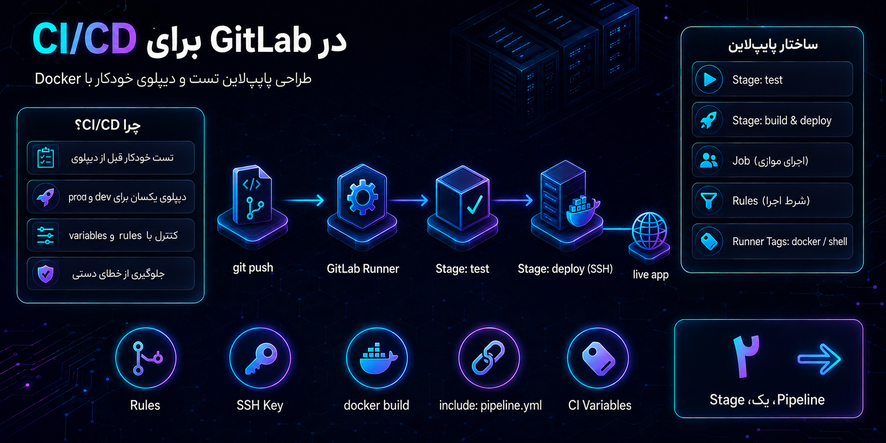
در این مقاله سعی میکنیم یک سناریو ساده برای یک پروژه ساده پایتونی با فریمورک flask رو پیاده سازی کنیم. این سناریو سه مرحله تست, بیلد و استقرار یا دیپلوی پروژه و قرار دادن ان روی اینترنت رو خودکار سازی میکنه و همچنین در طراحی پایپ لاین ها خیلی مهم هست که نکات امنیتی و منطقی برای مدیریت سرور ها رعایت بشود چون در صورت وجود داشتن ایراد منطقی یا امنیتی ممکنه به مشکلات گسترده و مهمی بر بخوریم. ( مثل مدیریت نکردن نسخه های قدیمی که توسط پایپ لاین اجرا شدن که باعث درگیر شدن تمام منابع سرور و در نهایت غیر قابل دسترس شدن سرور و پایین اومدن سرویس میشه یا نشت اطلاعات حساس حین اجرای پایپ لاین که امکان بوجود اوردن دسترسی های سطح بالا بدون احراز هویت به دیگران میدهد)
برای شروع یک سری مفاهیم پایه پایپ لاین نویسی در گیت لب رو مرور میکنیم
تنظیمات پایپ لاین برای گیت لب باید در فایلی با این نام نوشته شود و تنظیمات کلی پایپ لاین هر پروژه را میتوان از این مسیر دنبال و بررسی کرد
~/ ls
├── app.py
├── index.html
├── .gitlab-ci.yml  # the pipeline configuration file
└── Dockerfile
هر پایپ لاین شامل جاب(job) های مختلف هست. جاب ها نشون دهنده تسک ها و عملیات های مختلفی هستن که قراره توسط گیتلب رانر (gitlab runner) اجرا بشه مثل جاب test, جاب build, جاب deploy
برای تعریف کردن جاب به شکل زیر فایل گیتلب ci رو شروع میکنیم
test_job:
	image: python:3.9-slim-bookworm
	stage: test
	before_script:
		- apt update && apt install make -y
	script:
		- echo "doing test job"
		- echo "this is variable $VAR" # رانر مقدار VAL را جایگزین خواهد کرد
		- make test
	after_script:
		- echo "runs after script"
	tags:
	 - docker
نمونه بالا یک نمونه ساده از یک جاب برای ران کردن تست کیس های پروژه ازمایشی ما هست
اگر در مورد Gitlab Runner چیزی نمیدونید میتونید از مقاله نحوه راه اندازی و تنظیم Gitlab Runner شروع کنید.
برگردیم به پایپ لاینمون
خط اول اسم جاب رو مشخص میکنیم
خط دوم متغیر image هست که در صورت استفاده از داکر برای محیط اجرا شدن این جاب پایپ لاین ازش استفاده میکنیم و ایمیج داکری مورد نظرمون رو مشخص میکنیم
خط سوم stage هست که در ادامه توضیحش میدیم
خط بعدی before script هست که قبل از اجرا شدن دستورات script اجرا میشود
و در نهایت خط اخر script هست که بصورت لیست یا ارایه مقادیر تعریف میشن براش و هر خط نشون دهنده دستوری هست که نیازه که به ترتیب اجرا بشه
بطور کلی پایپ لاین مسیر زیر رو برای اجرا پیش میبره
مرحله(stage) -> جاب (job)
پایپلاین به مرحلهها تقسیم میشود که به ترتیب اجرا میشوند; اگر یک مرحله شکست بخورد، مراحل بعدی اصلاً اجرا نمیشوند. هر مرحله شامل چند جاب است و جابهای داخل یک مرحله بهصورت موازی اجرا میشوند.
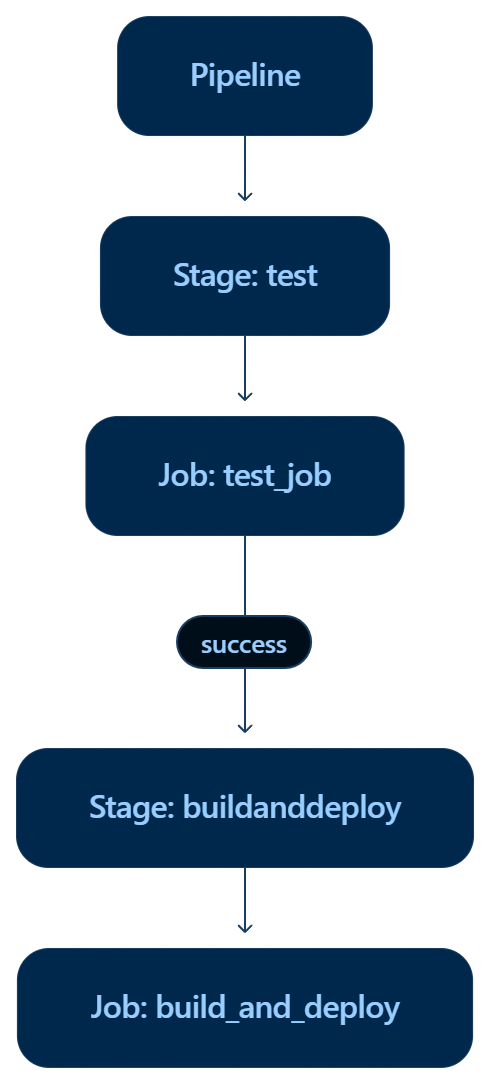
در ادامه به پایپ لاین طراحی شده نهایی میپردازیم و مفاهیم پیشرفته تر از طراحی پایپ لاین رو بررسی میکنیم
جاب تست
test_job:
  stage: test
  image: python:3.9-slim-bookworm
  rules:
    - if: $CI_MERGE_REQUEST_TARGET_BRANCH_NAME == "prod"
      variables:
        BRANCH: "merge test"
    - if: $CI_COMMIT_BRANCH == "dev"
      variables:
        BRANCH: "dev"
    - if: $CI_COMMIT_BRANCH == "prod"
      variables:
        BRANCH: "prod"
    - when: always
      variables:
        BRANCH: "unknown"
  before_script:
    - apt update
    - apt install make -y
  script:
    - echo "branch is $BRANCH"
    - make test
  tags:
    - docker
تعریف کردن rule در جاب ها
ما میتونیم برای هر جابی که توی پایپ لاین داریم شروطی مشخص کنیم که بتونیم از اون جاب بصورت کلی تر و جامع تری برای اتفاقات مختلفی که روی مخزن پروژه رخ میده استفاده کنیم. در اینجا در هر سناریویی یک دستور ساده اجرا میشه و دلیل قرار دادن شرط ها برای این جاب بیشتر جنبه اموزشی و بصورت واقعی مشاهده کردن اتفاقی هست که برای پایپ لاین میوفته (و البته اینکه برای سناریو مدنظرمون نیاز داشتیم که برای هر merge request رخ داده روی برنچ prod یک بار تست رو اجرا کنیم)
برای نوشتن rule از متغیر های عمومی که گیت لب برای هر جاب تعریف میکنه میتونیم استفاده کنیم. لیست این متغیر ها به شکل زیر هست
| Variable | Meaning | Typical use in rules: |
|---|---|---|
CI_COMMIT_BRANCH | The branch name for branch pipelines. Empty for tag pipelines. | اجرای جاب فقط برای کامیت های یک برنچ |
CI_COMMIT_TAG | The tag name for tag pipelines. Empty for branch pipelines. | Run jobs only for releases/tags. |
CI_PIPELINE_SOURCE | What started the pipeline, like push, merge_request_event, schedule, web, or api. | Differentiate push vs MR vs scheduled pipelines. |
CI_COMMIT_REF_NAME | The branch or tag name of the ref being built. | Match a ref without caring whether it is a branch or tag. |
CI_DEFAULT_BRANCH | Your project’s default branch, usually main or master. | Run jobs only on the default branch. |
CI_MERGE_REQUEST_ID | Present in merge request pipelines. | Detect MR pipelines. |
CI_MERGE_REQUEST_SOURCE_BRANCH_NAME | Source branch name of the merge request. | Target a specific MR source branch. |
CI_MERGE_REQUEST_TARGET_BRANCH_NAME | Target branch of the merge request. | Run only when an MR targets a branch like main. |
CI_OPEN_MERGE_REQUESTS | Indicates open merge requests for the branch. | Avoid duplicate branch pipelines when an MR exists. |
CI_COMMIT_REF_PROTECTED | true if the ref is protected. | Restrict jobs to protected branches/tags. |
CI_COMMIT_MESSAGE | Full commit message. | Skip or run jobs based on message text. |
CI_COMMIT_TITLE | First line of the commit message. | Match commit titles for special behavior. |
CI_PROJECT_PATH | Namespace/project path like group/project. | Limit jobs to specific projects in templates. |
CI_PROJECT_NAMESPACE | Top-level namespace or group. | Apply rules across a group of projects. |
CI_SERVER_HOST | GitLab host name. | Adjust behavior for self-managed vs SaaS setups. |
قواعد از بالا به پایین ارزیابی میشوند اولین تطابق برنده است
اگر هیچ قاعدهای تطابق نکند و Fallback هم نباشد، آن جاب بهسادگی به پایپلاین اضافه نمیشود. این خطا نیست؛ یک ویژگی است که در جاب دیپلوی از آن سوءاستفاده خواهیم کرد.
از روش هایی که توی rules پایپ لاین استفاده میشود مشخص کردن variable در صورت وارد شدن اون شرط بخصوص هست که توی این جاب نحوه طراحی و تنظیم کردن این رفتار رو میتونید ببینید
در مورد شرط اخر when: always هم نوعی مفهوم else توی بلاک های شرط برنامه نویسی رو داره و وقتی اجرا میشه که هیچکدوم از شرط ها موفق نبوده باشن، این Rule نقش یک fallback را دارد و اگر هیچکدام از Ruleهای قبلی match نشوند، Job را با BRANCH=unknown وارد Pipeline میکند.
جاب دیپلوی
build_and_deploy:
  stage: buildanddeploy
  rules:
    - if: $CI_COMMIT_BRANCH == "dev"
      variables:
        BRANCH: "dev"
        DEPLOY_PORT: 5000
    - if: $CI_COMMIT_BRANCH == "prod"
      variables:
        BRANCH: "prod"
        DEPLOY_PORT: 6000
  before_script:
    - chmod 400 $SSH_KEY
    - tar -czf pipeline-files.tar.gz $(git ls-files)
    - scp -o StrictHostKeyChecking=no -i "$SSH_KEY" pipeline-files.tar.gz root@203.0.113.10:/root/
  script:
    - |
      ssh -o StrictHostKeyChecking=no -i "$SSH_KEY" root@203.0.113.10 "
        mkdir -p /root/deploy && tar -xzf /root/pipeline-files.tar.gz -C /root/deploy && cd /root/deploy
        docker ps -aq --filter name=python-app-$BRANCH | xargs -r docker stop &&
        docker ps -aq --filter name=python-app-$BRANCH | xargs -r docker rm &&
        docker build -t python-proj-$BRANCH . &&
        docker run --name python-app-$BRANCH --restart unless-stopped -p $DEPLOY_PORT:5000 -d python-proj-$BRANCH"
  tags:
    - shell
نکاتی که در وهله اول در مورد این جاب به چشم میخورد یکی این هست که مقداری برای image مشخص نشده. دلیل این موضوع اینه که تگ این جاب رو برای تسک خاصی که نیازه انجام بده روی shell تنظیم کردیم و دستورات مستقیما روی ماشین گیتلب رانر اجرا خواهد شد و نیازی به اجرای کانتینر و محیط ایزوله شده نیست
نکته دوم توی تعریف rule ها هست که بدون شرط else نوشته شده این یک الگوی امنیتی هست که به دلیل اهمیت بالای دیپلوی کردن روی سرور اصلی باید مطمین باشیم که خارج از شروط تعریف شده این جاب اجرا نشود
نکته سوم ساختار اسکریپت و استفاده از متغیر ها درون اسکریپت و الگوی before_script هست
کاری که ما میخوایم توی این جاب انجام بدیم اینه که از توی ماشین گیتلب رانر که کل محتوای پروژه رو در محیطش داره برداریم و به سرور منتقل کنیم و از اونجا فرایند بیلد کردن ایمیج و دیپلوی کردن اون رو انجام بدیم (به دلیل پیچیدگی و دسترسی های امنیتی بالایی که روش docker in docker داره از این راه استفاده میکنیم). برای انتقال محتوای اپدیت شده بعد از کامیت یا هر ایونت دیگری که باعث ران شدن پایپ لاین شده از دستور tar استفاده میکنیم
خط tar -czf pipeline-files.tar.gz $(git ls-files) بستهبندی پروژه. git ls-files لیست فایلهایی را که Git در حال track کردن آنهاست برمیگرداند؛ بنابراین فایلهای untracked، از جمله فایلهایی که توسط .gitignore نادیده گرفته شدهاند، در این خروجی قرار نمیگیرند.
بعد از درست شدن فایل فشرده شده اون رو با دستور scp به سرور منتقل میکنیم که در این دستور هم از دو اپشن -i و StrictHostKeyChecking=no استفاده میکنیم تا تعاملی بودن فرایند انتقال فایل به سرور رو بطور کامل حذف کنیم (چون در پایپ لاین تسک های تعاملی بطور کامل جاب را قفل و پایپ لاین را fail میکنن)
در این مثال برای جلوگیری از interactive prompt از StrictHostKeyChecking=no استفاده شده، اما این گزینه از نظر امنیتی ایدهآل نیست، چون بررسی معمول host key را غیرفعال میکند. در محیط production بهتر است host key سرور مقصد در known_hosts Runner ثبت و اعتبارسنجی شود.
فلگ -i هم برای پاس دادن مسیر ssh key برای اتصال مستقیم بدون نیاز به پسورد هست که در مقاله نحوه اضافه کردن SSH KEY به پایپ لاین نکات انجام دادن این کار رو توضیح دادیم
بعد از این کار فرایند انتقال فایل های بروز شده پروژه به سرور انجام میشه و ما به مرحله بعد یعنی اجرای دستورات بیلد و دیپلوی میرسیم
تو این مرحله هم در ابتدا به مسیری که فایل tar پروژه رو ارسال کرده بودیم میریم و بعد با دستور tar اون رو از حالت فشرده شده درمیاریم. بعد از اون با دستورات docker بررسی میکنیم که اگر ایمیج یا کانتینری از نوع و نام کانتینر مورد نظرمون در حال اجرا هست اول stop و سپس remove بشه تا تداخلی برای اجرای دوباره نسخه جدیدتر اون وجود نداشته باشه
و بعد از متغیر هایی که توی rule ها ساخته و مقدار دهی میشن با توجه به شرایطی که رخ داده ایمیج مورد نظرمون رو با اسم و روی پورت مشخص شده بالا میاریم.
این روش برای ساده نگه داشتن سناریوی آموزشی انتخاب شده و برای deploymentهای production در مقیاس بزرگ، استفاده از Container Registry و pull کردن image روی سرور معمولاً معماری مناسبتری است.
مواظب کوتیشنهایتان در SSH باشید
دستور SSH عمداً داخل دابلکوتیشن قرار گرفته است. با سینگلکوتیشن، $BRANCH و $DEPLOY_PORT بهصورت تحتاللفظی به سرور راه دور فرستاده میشدند — که هیچخبری از این متغیرها ندارد — و به رشته خالی باز میشدند. دابلکوتیشن به شل رانر اجازه میدهد مقادیر را قبل از سفر دستور روی SSH جایگذاری کند.
یک پایپلاین برای همه برنچها
در ساختاری که تا اینجا دیدیم یک تله نگهداری پنهان است: .gitlab-ci.yml داخل هر برنچ زندگی میکند. اگر باگی در پایپلاین روی dev درست کنید، باید یادتان باشد آن فیکس را به prod هم مرج کنید، وگرنه دو برنچ کمکم به سمت اجرای اتوماسیونهای متفاوت منحرف میشوند.
راهحل: منطق واقعی پایپلاین را یک جا متمرکز کنید و .gitlab-ci.yml هر برنچ را به یک اشارهگر نازک تبدیل کنید:
# .gitlab-ci.yml on dev, prod, and any other branch
include:
  - project: $CI_PROJECT_PATH # 'your-group/your-project'
    ref: main
    file: '/ci/pipeline.yml'
حالا منطق پایپلاین دقیقاً در یک فایل زندگی میکند (ci/pipeline.yml روی main) و هر برنچ، در اجرای بعدیاش، تغییرات را خودکار میگیرد.
جمعبندی
در این مقاله یک سناریوی ساده اما واقعی از طراحی CI/CD با GitLab را پیادهسازی کردیم؛ از اجرای تستها در یک محیط Docker گرفته تا استفاده از rules برای کنترل نحوه اجرای Jobها و در نهایت انتقال و استقرار نسخه جدید روی سرور با SSH و Docker.
هدف اصلی این بود که علاوه بر نوشتن دستورات Pipeline، با بخشی از تصمیمهای مهم در طراحی آن هم آشنا شویم؛ مثل محدود کردن Jobهای حساس، مدیریت متغیرها، توجه به امنیت اتصال SSH و در نظر گرفتن مشکلاتی که ممکن است هنگام Deployment رخ دهد.
این سناریو نقطه شروعی برای Pipelineهای پیچیدهتر است و در پروژههای واقعی میتوان آن را با مفاهیمی مانند artifacts، cache، Container Registry و روشهای پیشرفتهتر Deployment توسعه داد.